TL;DR
- React Compiler는 Babel 플러그인 형태의 빌드 도구입니다. 컴포넌트와 훅 안의 값, 함수, JSX를 분석해
useMemo,useCallback,memo와 같은 효과를 내는 캐시 코드를 자동으로 끼워 넣습니다.- 코드를 고칠 필요는 없지만, React 규칙을 지키는 코드여야 합니다. 규칙을 어긴 컴포넌트는 에러를 내지 않고 조용히 컴파일을 건너뜁니다.
- 메모이제이션의 단위는 컴포넌트가 아니라 컴포넌트 안의 값입니다.
count가 바뀌어도count와 무관한 JSX는 이전 엘리먼트를 그대로 재사용하기 때문에, 자식 컴포넌트를memo로 감싸지 않아도 리렌더링이 건너뛰어집니다.- 효과는 첫 화면을 그릴 때가 아니라 클릭이나 입력으로 화면이 갱신될 때 나타납니다. 부모의 상태가 바뀔 때 무관한 자식까지 함께 리렌더링되던 앱일수록 효과가 크고, 외부 라이브러리가 렌더링마다 새 객체를 넘기는 곳은 컴파일러도 잡지 못합니다.
- 2025년 10월 1.0 정식 버전이 나왔고, React 17 이상에서 쓸 수 있습니다. Next.js는
reactCompiler: true한 줄로 켤 수 있습니다."use no memo"지시어로 컴포넌트 하나를 빼거나,compilationMode: 'annotation'으로"use memo"를 붙인 컴포넌트만 컴파일하는 식으로 점진적으로 도입할 수 있습니다.
React는 상태가 바뀌면 그 컴포넌트와 하위 컴포넌트 전체를 다시 실행합니다. 이 단순한 모델이 React를 배우기 쉽게 만들었지만, 앱이 커지면 바뀐 것이 없는 자식까지 매번 실행되는 비용이 문제가 됩니다. 그래서 useMemo, useCallback, memo로 "이 값은 저 값이 바뀔 때만 다시 계산해"라고 React에 알려 주는 수동 메모이제이션을 해 왔습니다.
React Compiler(개발 당시 이름은 React Forget)는 이 작업을 사람 대신 빌드 도구가 하도록 만든 것입니다. 2024년 React Conf에서 오픈 소스로 공개되고, 2025년 10월 7일 1.0 정식 버전이 나왔습니다. 이번 포스트에서는 컴파일러가 코드를 어떻게 바꾸는지, 어떤 코드에서 컴파일을 포기하는지, 그리고 프로젝트에 어떻게 적용하는지 살펴보도록 하겠습니다.
수동 메모이제이션의 문제
컴파일러가 왜 필요한지 보기 위해, 먼저 지금까지 해 오던 방식의 문제를 짚어 보겠습니다.
const FriendList = ({ friends }: { friends: Friend[] }) => {
  const [filter, setFilter] = useState('')
  const visible = useMemo(
    () => friends.filter((f) => f.name.includes(filter)),
    [friends, filter],
  )
  const onChange = useCallback((e: ChangeEvent<HTMLInputElement>) => {
    setFilter(e.target.value)
  }, [])

  return (
    <div>
      <input value={filter} onChange={onChange} />
      <ul>
        {visible.map((f) => (
          <li key={f.id}>{f.name}</li>
        ))}
      </ul>
      <MessageButton />
    </div>
  )
}
이 코드에는 세 가지 문제가 있습니다.
- 번거롭고 읽기 어렵습니다.
핵심 로직은friends.filter(...)한 줄인데, 메모이제이션을 위해useMemo와 의존성 배열이 둘러싸고 있습니다. 코드의 절반이 React를 위한 힌트입니다. - 실수하기 쉽습니다.
의존성 배열에서 값을 빠뜨리면 오래된 값을 보여 주는 버그가 생기고, 불필요한 값을 넣으면 메모이제이션이 무의미해집니다. ESLint의exhaustive-deps규칙이 도와주지만, 객체와 함수 참조가 얽히면 규칙만으로는 부족합니다. - 한 곳만 빠져도 전체가 무너집니다.
MessageButton은 props가 없는데도FriendList가 리렌더링될 때마다 같이 실행됩니다.memo로 감싸야 건너뛸 수 있습니다. 그리고memo로 감싼 컴포넌트에onClick={() => handleClick(item)}처럼 인라인 함수를 넘기면 매번 새 함수라memo가 무력화됩니다. 메모이제이션은 부모부터 자식까지 빈틈없이 이어져야 효과가 있는데, 이를 사람이 유지보수하기는 쉽지 않습니다.
컴파일러를 사용하면 이 세 가지를 모두 해결할 수 있습니다. 컴파일러가 빠짐없이 정확한 메모이제이션을 넣기 때문에 사람은 더 이상 메모이제이션을 신경 쓰지 않아도 됩니다.
컴파일러가 하는 일
컴파일러가 실제로 코드를 어떻게 바꾸는지 보겠습니다. 아래의 Counter 컴포넌트를 babel-plugin-react-compiler 1.0.0으로 변환해 보겠습니다.
const Counter = ({ items }: { items: number[] }) => {
  const [count, setCount] = useState(0)
  const total = sum(items)
  const onClick = () => setCount(count + 1)
  return (
    <div>
      <p>{total}</p>
      <button onClick={onClick}>{count}</button>
      <Child />
    </div>
  )
}
컴파일하면 아래와 같은 코드가 됩니다.
import { c as _c } from 'react/compiler-runtime'

const Counter = (t0) => {
  const $ = _c(13)
  const { items } = t0
  const [count, setCount] = useState(0)

  let t1
  if ($[0] !== items) {
    t1 = sum(items)
    $[0] = items
    $[1] = t1
  } else {
    t1 = $[1]
  }
  const total = t1

  let t2
  if ($[2] !== count) {
    t2 = () => setCount(count + 1)
    $[2] = count
    $[3] = t2
  } else {
    t2 = $[3]
  }
  const onClick = t2

  let t3
  if ($[4] !== total) {
    t3 = <p>{total}</p>
    $[4] = total
    $[5] = t3
  } else {
    t3 = $[5]
  }

  let t4
  if ($[6] !== count || $[7] !== onClick) {
    t4 = <button onClick={onClick}>{count}</button>
    $[6] = count
    $[7] = onClick
    $[8] = t4
  } else {
    t4 = $[8]
  }

  let t5
  if ($[9] === Symbol.for('react.memo_cache_sentinel')) {
    t5 = <Child />
    $[9] = t5
  } else {
    t5 = $[9]
  }

  let t6
  if ($[10] !== t3 || $[11] !== t4) {
    t6 = <div>{t3}{t4}{t5}</div>
    $[10] = t3
    $[11] = t4
    $[12] = t6
  } else {
    t6 = $[12]
  }
  return t6
}
길어 보이지만 같은 패턴이 반복될 뿐입니다. 하나씩 읽어 보겠습니다.
캐시 배열($) 만들기
_c(13)은 react/compiler-runtime이 제공하는 함수로, 칸이 13개인 캐시 배열을 만듭니다. 컴파일된 코드 첫 줄의 const $ = _c(13)에서 보듯 이 배열은 $라는 변수에 담기고, 이후 $[0], $[1]처럼 칸 번호로 접근합니다. 컴파일러가 이 컴포넌트에서 기억해 둘 값의 개수를 세어 13이라는 숫자를 정합니다. 이 배열은 useState의 상태처럼 컴포넌트 인스턴스마다 하나씩 생기고, 다시 렌더링될 때 같은 배열을 그대로 돌려받습니다(실제로 훅으로 구현되어 있습니다). 처음에는 모든 칸이 Symbol.for('react.memo_cache_sentinel')이라는 "아직 계산하지 않았음" 표시로 채워져 있어서, 컴파일된 코드는 이 표시를 보고 첫 렌더링인지 판단합니다.
Reactive Scope로 묶기
if ($[0] !== items) { ... } else { ... } 블록 하나가 메모이제이션의 단위입니다. 컴파일러는 이것을 Reactive Scope라고 부릅니다. 각 블록은 다음 구조로 되어 있습니다.
- 의존성 칸:
$[0]에 지난번 렌더링 때의items를 저장합니다. - 출력 칸:
$[1]에sum(items)의 결과를 저장합니다. - 비교: 이번 렌더링의
items가$[0]과 다르면(!==) 다시 계산하고 두 칸을 갱신합니다. 같으면$[1]을 꺼내 씁니다.
useMemo(() => sum(items), [items])를 손으로 풀어 쓴 것과 같습니다. 차이는 사람이 의존성 배열을 적는 대신 컴파일러가 코드를 분석해 items를 찾아냈다는 점입니다.
onClick도 같은 방식으로 count에 의존하는 Reactive Scope가 됩니다. useCallback(() => setCount(count + 1), [count])와 같습니다. <Child />는 아무 값에도 의존하지 않아 비교할 의존성 칸이 없습니다. 캐시 칸에 "아직 계산하지 않았음" 표시(sentinel)가 남아 있는지만 확인해서, 첫 렌더링에 한 번 만든 뒤로는 계속 재사용합니다.
JSX 엘리먼트도 묶기
컴파일러의 특징은 JSX 엘리먼트도 메모이제이션 대상이라는 점입니다. 컴파일 결과에서 엘리먼트를 담는 변수들을 따라가 보면 다음과 같습니다.
| 변수 | 값 | 의존하는 것 |
|---|---|---|
t3 | <p>{total}</p> | total |
t4 | <button onClick={onClick}>{count}</button> | count, onClick |
t5 | <Child /> | 없음 (최초 한 번만 생성) |
t6 | <div>{t3}{t4}{t5}</div> | t3, t4 |
<p>는 total에, <button>은 count와 onClick에 의존하는 Reactive Scope로 각각 묶였습니다. 마지막 <div> 블록을 다시 보겠습니다.
let t6
if ($[10] !== t3 || $[11] !== t4) {
  t6 = <div>{t3}{t4}{t5}</div>
  $[10] = t3
  $[11] = t4
  $[12] = t6
} else {
  t6 = $[12]
}
return t6<div>의 자식은 t3, t4, t5 세 엘리먼트입니다. 이 셋은 이미 각각 메모이제이션되어 있어서 입력이 바뀌지 않으면 이전과 같은 객체입니다. 그래서 <div>를 새로 만들지 말지는 total이나 count 같은 원래 값을 다시 볼 필요 없이, 자식 엘리먼트 t3, t4가 이전과 같은 객체인지만 보면 됩니다. t5는 절대 바뀌지 않아 비교 조건에서 아예 빠져 있습니다.
결과적으로 의존 관계가 사슬처럼 이어집니다.
count가 바뀌면onClick과t4가 새로 만들어지고,t4가 바뀌었으니<div>도 새로 만들어집니다. 하지만 그 안의t3,t5는 이전 객체 그대로입니다.items가 바뀌면total과t3가 새로 만들어지고,<div>도 새로 만들어집니다.t4,t5는 그대로입니다.- 둘 다 바뀌지 않았으면
t3,t4가 그대로라<div>도 캐시에서 꺼냅니다. 컴포넌트가 지난번과 완전히 같은 엘리먼트 트리를 반환하는 것입니다.
컴파일러는 이렇게 메모이제이션을 바깥 엘리먼트까지 겹겹이 쌓아서, 바뀐 가지만 새로 만들고 나머지 가지는 이전 객체를 그대로 끼워 넣습니다.
React는 컴포넌트가 돌려준 자식 엘리먼트가 이전 렌더링과 같은 객체이면, 그 자식 컴포넌트를 다시 실행하지 않고 지난 결과를 그대로 씁니다. 위 사슬에서 t5(<Child />)는 한 번 만들어진 뒤 항상 같은 객체라, Child는 memo로 감싸지 않아도 다시 실행되지 않습니다. memo가 하던 일을 컴파일러가 부모 쪽에서 대신해 주는 셈입니다.
수동 메모이제이션보다 촘촘하게
수동 메모이제이션은 사람이 고른 지점에서만 동작합니다. useMemo와 useCallback은 감싼 값 하나를, memo는 감싼 컴포넌트의 리렌더링 여부를 메모이제이션하고, 감싸지 않은 나머지는 매번 다시 계산됩니다. 컴파일러는 컴포넌트 안의 모든 값과 모든 JSX 엘리먼트에 대해 각각 "다시 계산하느냐 마느냐"를 결정합니다. React 팀은 이것을 세밀한 반응성(Fine-grained Reactivity)이라고 부릅니다.
앞에서 본 인라인 함수 문제가 어떻게 해결되는지 아래 코드로 살펴보겠습니다.
const List = ({ items, onSelect }) => (
  <ul>
    {items.map((item) => (
      <Item key={item.id} onClick={() => onSelect(item)} />
    ))}
  </ul>
)
컴파일 전에는 List가 리렌더링될 때마다 items.map(...)이 다시 실행되고, 행마다 () => onSelect(item) 화살표 함수가 새로 만들어집니다. Item을 memo로 감싸 두어도 memo는 props를 Object.is로 비교하기 때문에, 매번 다른 onClick 함수를 보고 props가 바뀌었다고 판단해 Item을 전부 다시 렌더링합니다. 이를 막으려면 행마다 onClick 함수가 렌더링 사이에 같은 참조를 유지하도록 해야 하는데, 반복문 안에서는 useCallback을 쓸 수 없어 컴포넌트 구조를 바꿔야 했습니다.
컴파일러를 쓰면 구조를 바꾸지 않아도 됩니다. 컴파일 후 items.map(...) 부분은 아래처럼 바뀝니다.
let t1
if ($[0] !== items || $[1] !== onSelect) {
  let t2
  if ($[3] !== onSelect) {
    t2 = (item) => <Item key={item.id} onClick={() => onSelect(item)} /> // 콜백도 onSelect 기준으로 캐시
    $[3] = onSelect
    $[4] = t2
  } else {
    t2 = $[4]
  }
  t1 = items.map(t2)
  $[0] = items
  $[1] = onSelect
  $[2] = t1
} else {
  t1 = $[2] // 이전 렌더링의 <Item> 엘리먼트 배열을 그대로 재사용
}map의 결과 전체가 items와 onSelect에만 의존하는 Reactive Scope로 묶였습니다. 부모의 무관한 상태 변경으로 List가 리렌더링되더라도 items와 onSelect가 그대로면 map을 실행하지 않고 지난번에 만든 <Item> 엘리먼트 배열을 캐시에서 꺼냅니다. <Item> 엘리먼트가 이전 렌더링과 같은 객체라 React는 Item을 다시 실행하지 않습니다. Item을 memo로 감싸거나 onClick을 useCallback으로 고정하지 않아도 같은 결과가 됩니다.
다만 items가 바뀌면 map이 다시 실행되고 화살표 함수도 전부 새로 만들어져 모든 Item이 리렌더링됩니다. 컴파일러가 하는 일은 행마다 onClick 참조를 유지하는 것이 아니라, items와 onSelect가 그대로일 때 리스트 전체를 통째로 건너뛰는 것입니다. 한 행만 바뀌었을 때 그 행만 리렌더링하고 싶다면 컴파일러만으로는 부족하고, 데이터 구조나 컴포넌트 분리를 직접 신경 써야 합니다.
컴포넌트 밖으로 끌어올리기
앞의 FriendList를 컴파일하면 visible.map((f) => <li key={f.id}>{f.name}</li>)의 콜백이 컴포넌트 밖으로 빠져나갑니다.
t4 = visible.map(_temp)
// ...
function _temp(f_0) {
  return <li key={f_0.id}>{f_0.name}</li>
}
콜백이 컴포넌트의 어떤 값도 참조하지 않는다면 매 렌더링마다 새로 만들 이유가 없습니다. 컴파일러는 이런 함수를 모듈 수준으로 끌어올려 아예 한 번만 만듭니다.
컴파일 과정
컴파일러는 Babel 플러그인이지만, 핵심 로직은 Babel과 분리된 별도의 컴파일러입니다. Babel은 소스를 AST로 파싱해 넘겨 주는 입구이고, 컴파일러는 AST를 자체 중간 표현인 HIR(High-level Intermediate Representation)로 바꿔 분석합니다.
- AST(Abstract Syntax Tree): 소스 코드를 트리 구조로 표현한 것입니다.
a + b라면+노드 아래에a와b가 자식으로 달리는 식입니다. Babel, ESLint, Prettier가 모두 이 형태로 코드를 다룹니다.- 중간 표현(IR, Intermediate Representation): 컴파일러가 분석하기 쉽도록 소스를 바꿔 놓은 내부 형식입니다. AST는 사람이 쓴 문법 그대로라 "이 값이 어디서 바뀌는가" 같은 질문에 답하기 불편해서, 대부분의 컴파일러는 자기만의 IR을 따로 둡니다.
- HIR(High-level Intermediate Representation): React Compiler의 IR입니다. 함수 본문을 분기가 없는 코드 블록 단위로 쪼개고, 각 값에 한 번만 이름을 붙여서 값의 생성, 변경, 의존 관계를 추적하기 쉽게 만든 형태입니다.
-
컴포넌트와 훅 찾기: 기본 설정(
compilationMode: 'infer')에서는 대문자로 시작하는 이름의 함수를 컴포넌트로,use로 시작하는 이름의 함수를 훅으로 보되, 그중 JSX를 만들거나 다른 훅을 호출하는 함수만 컴파일합니다. -
분석: HIR 위에서 각 값이 어디서 만들어지고(①) 어디서 변경되는지(②), 그리고
const b = a처럼 두 이름이 같은 객체를 가리키는 별칭 관계(③)를 추적합니다. 이 분석 결과로 "이 값은 저 값에 의존한다"는 그래프가 만들어집니다.이 분석이 왜 필요한지 예로 보겠습니다.
alias는list와 같은 배열을 가리키기 때문에,alias.push도list를 바꾸는 코드입니다.const Tags = ({ items, label }) => { const list = [] // ① 만들어지는 곳 list.push(items[0]) // ② 변경되는 곳 const alias = list // ③ 별칭: alias 와 list 는 같은 배열 alias.push(items[1]) // ② 변경되는 곳: list 도 함께 바뀜 const title = label.toUpperCase() return <ul title={title}>{list.map((t) => <li key={t}>{t}</li>)}</ul> }값은 마지막 변경이 끝난 뒤에야 캐시할 수 있습니다. 별칭을 놓치고
list.push직후에 캐시했다면items[1]이 빠진 배열이 재사용됐을 것입니다. 그래서 컴파일러는 별칭을 추적해alias.push까지를list의 변경 구간으로 잡습니다. 분석이 끝나면 "list는items[0]과items[1]에 의존하고,title은label에 의존한다"는 그래프가 남습니다. -
규칙 검사: 분석 중에 React 규칙 위반이 발견되면 그 함수는 컴파일하지 않고 원본 그대로 출력합니다. 컴파일은 함수 단위로 독립적이라, 파일에 컴포넌트가 다섯 개 있고 하나가 규칙을 어겼다면 나머지 넷만 컴파일됩니다. React 규칙과 컴파일 건너뛰기 절에서 자세히 봅니다.
-
Reactive Scope 결정과 코드 생성: 의존성이 같은 값들을 하나의 Reactive Scope로 묶고, 캐시 배열의 칸을 할당한 뒤
if/else코드로 다시 출력합니다. 2번에서 분석한Tags의list는 생성부터 마지막 변경까지가 하나의 스코프가 되고, 의존성도items전체가 아니라 실제로 읽은items[0]과items[1]로 잡힙니다.let list if ($[0] !== items[0] || $[1] !== items[1]) { list = [] list.push(items[0]) const alias = list alias.push(items[1]) // 마지막 변경까지 한 스코프에 묶임 $[0] = items[0] $[1] = items[1] $[2] = list } else { list = $[2] }list와 무관한title은label에만 의존하는 별도 스코프가 됩니다.
React 규칙과 컴파일 건너뛰기
컴파일러가 안전하게 메모이제이션하려면 두 가지 전제가 필요합니다. 같은 입력에 항상 같은 출력이 나와야 캐시한 값을 그대로 돌려줄 수 있고, 렌더링 중에 바깥 상태를 바꾸지 않아야 계산을 건너뛰어도 빠지는 일이 없습니다. 이 두 전제는 React가 오래전부터 문서화해 온 React 규칙과 같습니다.
React 규칙
컴파일러가 검사하는 규칙은 아래 네 가지입니다.
-
컴포넌트와 훅은 순수해야 합니다. 렌더링 중에 props, state, 외부 변수를 변경하지 않습니다.
// This value cannot be modified const A = ({ user }) => { user.name = 'x' // props 변경 return <div>{user.name}</div> } -
훅은 최상위에서, 매번 같은 순서로 호출합니다.
// Hooks must always be called in a consistent order, and may not be called conditionally const B = ({ on }) => { if (on) { const [s] = useState(0) // 조건부 훅 return <div>{s}</div> } return null } -
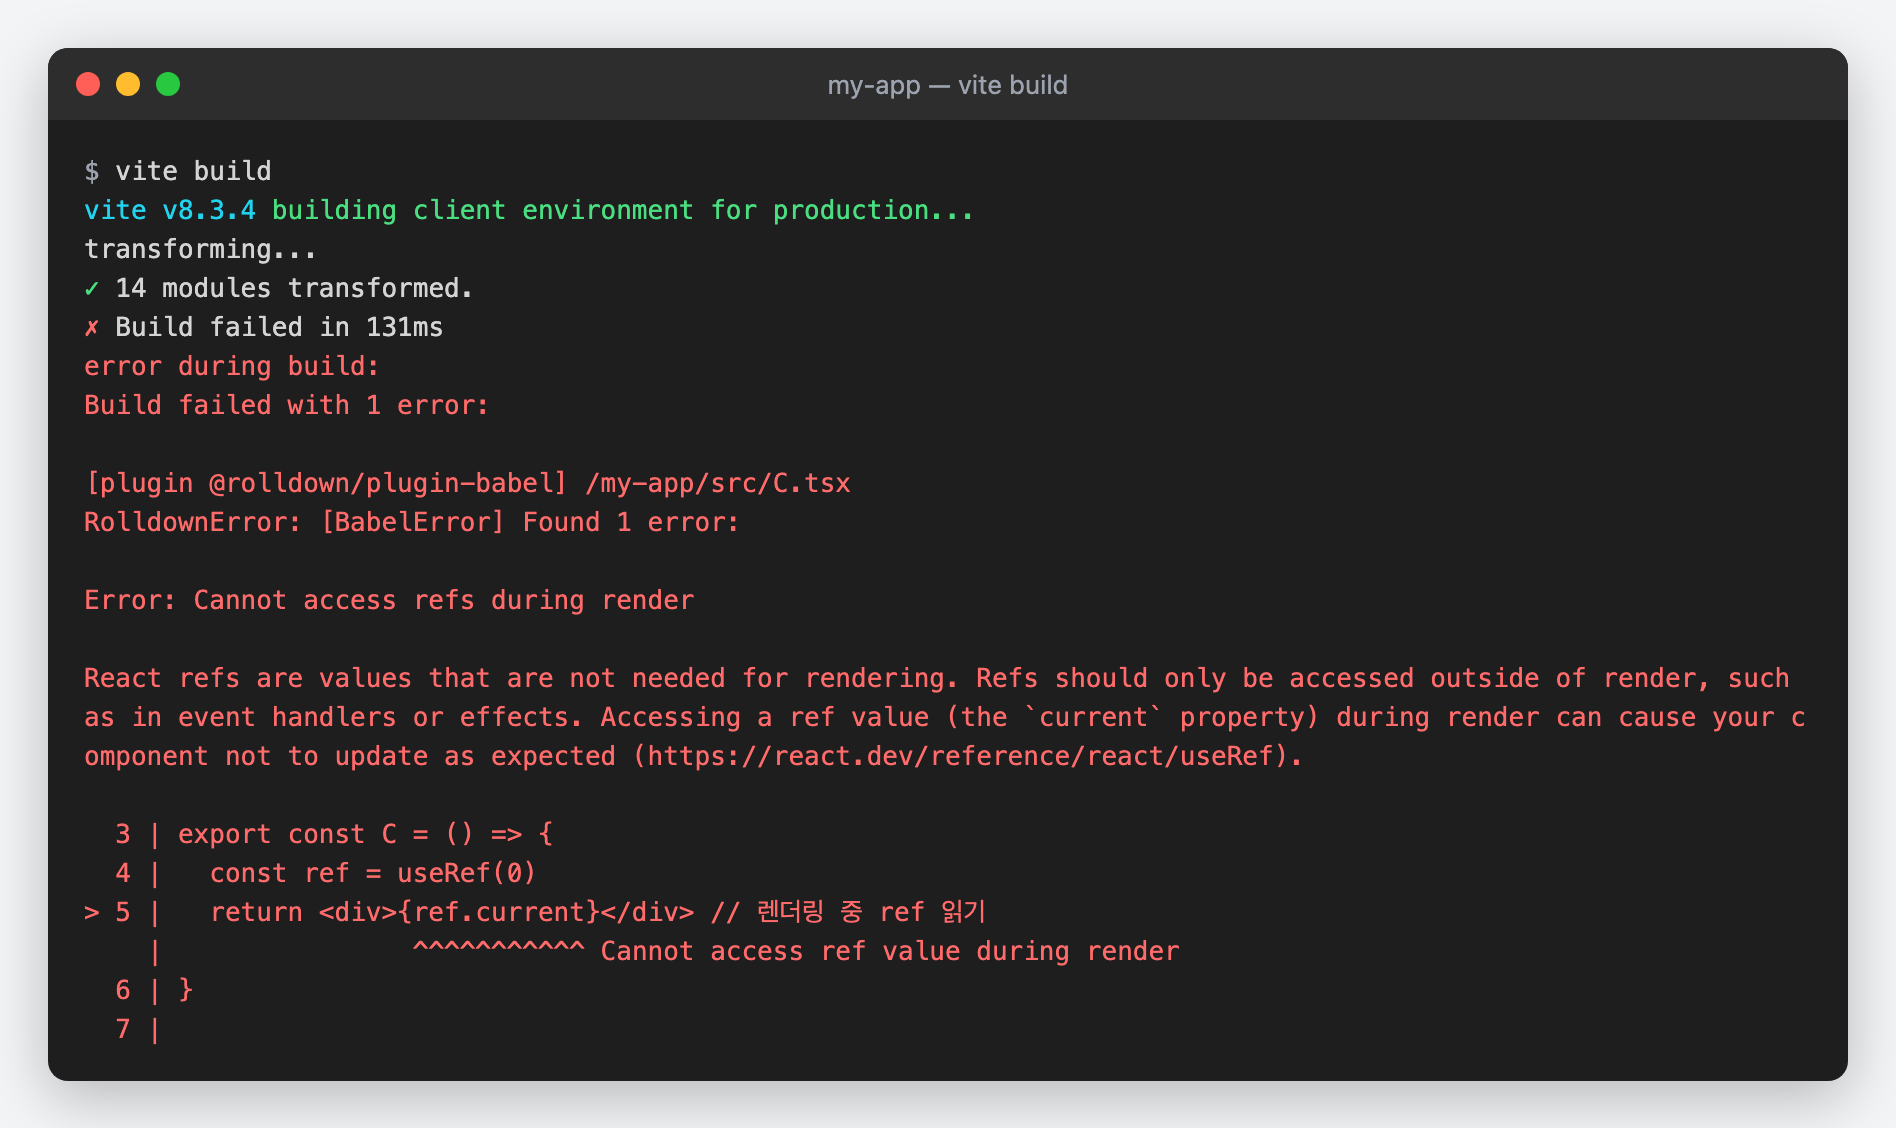
ref.current는 렌더링 중에 읽거나 쓰지 않습니다. ref는 바뀌어도 리렌더링을 일으키지 않아 렌더링 중에 읽은 값이 화면과 어긋날 수 있기 때문에, 컴파일러가 규칙 위반으로 판단합니다. 화면에 렌더링되어야 하는 값이면 state를 사용하고, 첫 렌더링에 한 번만 초기화하는if (ref.current === null) ref.current = ...형태는 허용됩니다.// Cannot access refs during render const C = () => { const ref = useRef(0) return <div>{ref.current}</div> // 렌더링 중 ref 읽기 } -
렌더링 중에
setState를 무조건 호출하지 않습니다.if (prev !== count)처럼 조건을 걸어 이전 렌더링의 값과 비교하는 패턴은 조건이 거짓이 되면 멈추기 때문에 허용되며, 컴파일러와 lint 모두 통과시킵니다.// Calling setState during render may trigger an infinite loop const D = () => { const [a, setA] = useState(0) setA(1) // 렌더링 중 setState return <div>{a}</div> }
ESLint로 미리 찾기
eslint-plugin-react-hooks를 사용하면 규칙 위반을 미리 찾을 수 있습니다. 컴파일러 1.0과 함께 나온 eslint-plugin-react-hooks 7.0부터는 컴파일러의 분석 엔진으로 동작하는 규칙이 기본 recommended 프리셋에 포함되어, 컴파일러와 같은 기준으로 규칙 위반을 lint 에러로 볼 수 있습니다. 컴파일러를 설치하지 않아도 lint만 따로 쓸 수 있습니다.
// eslint.config.js
import reactHooks from 'eslint-plugin-react-hooks'
import { defineConfig } from 'eslint/config'

export default defineConfig([reactHooks.configs.flat.recommended])
recommended 프리셋에 set-state-in-render, set-state-in-effect, refs, immutability 같은 규칙이 포함되어 있습니다. 별도 패키지였던 eslint-plugin-react-compiler는 이 플러그인으로 통합되었기 때문에, 설치되어 있다면 제거하면 됩니다.
컴파일 건너뛰기
컴파일러는 위에서 살펴본 네 가지 규칙을 지킨다고 가정하고 코드를 바꿉니다. 규칙을 어긴 코드가 발견되면 빌드를 실패시키는 대신 그 함수만 컴파일하지 않고 원본 그대로 둡니다.
다만 기본 설정에서는 규칙을 위반해도 아무 알림 없이 조용히 건너뛸 뿐, 위 주석 같은 이유를 터미널이나 콘솔에 보여주지 않습니다. 건너뛴 컴포넌트는 컴파일 전과 똑같이 동작하기 때문에 어느 컴포넌트가 빠졌는지 모르고 지나치기 쉽습니다. 앞의 ESLint 플러그인이 컴파일러와 같은 기준으로 검사하기 때문에, lint를 통과시켜 두면 규칙 위반으로 건너뛰는 컴포넌트는 대부분 사라집니다. 또한 객체나 함수를 반환하는 useMemo, useCallback의 의존성 배열 누락처럼 exhaustive-deps 경고로만 나오는 경우도 컴파일러는 그 컴포넌트를 건너뛰기 때문에, 경고까지 없애 두는 것이 좋습니다.
컴파일러가 잡지 못하는 위반
컴파일러의 분석은 정적 분석이라 한계가 있습니다. 아래 코드는 props로 받은 배열을 sort()로 정렬하는데, 컴파일러는 Array.prototype.sort가 배열을 변경한다는 것을 모델링하지 않아 그냥 컴파일합니다.
const E = ({ list }) => {
  const sorted = list.sort() // list 자체가 바뀜
  return <div>{sorted.length}</div>
}
이 코드는 컴파일 전에도 문제가 있습니다. sort()는 새 배열을 만들지 않고 원본 배열의 순서를 직접 바꾸기 때문에, 부모가 같은 배열을 다른 곳에서도 쓰고 있다면 그쪽 순서까지 바뀝니다. 컴파일 후에는 list 참조가 같을 때 sort()를 건너뛰고 캐시한 sorted를 돌려줍니다. 배열은 첫 렌더링 때 이미 정렬되어 있으니 화면은 그대로지만, 매 렌더링마다 실행되던 sort()가 한 번만 실행되도록 동작이 바뀌게 됩니다. 컴파일러는 규칙을 지킨 코드를 전제로 변환하기 때문에, 규칙 위반이 남아 있으면 이렇게 컴파일 전후의 동작이 미묘하게 달라질 수 있습니다.
설치
babel-plugin-react-compiler를 설치하고 빌드 도구에 연결합니다. React 팀은 1.0 발표 글에서 테스트 커버리지가 충분하지 않다면 버전을 정확히 고정(npm·pnpm은 --save-exact, yarn은 --exact)하고 직접 올리라고 권장합니다.
yarn add -D --exact babel-plugin-react-compiler@latestBabel
플러그인 목록의 가장 앞에 둡니다. 다른 플러그인이 코드를 먼저 바꾸면 컴파일러의 분석이 원본 소스와 달라질 수 있기 때문입니다.
// babel.config.js
module.exports = {
  plugins: [
    'babel-plugin-react-compiler', // 반드시 첫 번째
    // ...
  ],
}
Next.js
Next.js 16부터 reactCompiler 옵션이 정식 옵션이 되었습니다(15.x에서는 experimental.reactCompiler). Next.js는 기본 컴파일러인 SWC(Rust로 만든 Babel 대체 컴파일러)로 먼저 파일을 훑어 JSX나 훅이 있는 파일만 골라 Babel 플러그인을 돌리기 때문에, Babel을 전체에 거는 것보다 빌드가 빠릅니다.
// next.config.ts
import type { NextConfig } from 'next'

const nextConfig: NextConfig = {
  reactCompiler: true,
}

export default nextConfig
Vite
@vitejs/plugin-react 6(Vite 8)부터는 내부 Babel이 빠지고 oxc(Vite 개발사 VoidZero가 Rust로 개발하는 JavaScript 도구 모음) 기반으로 바뀌어, @rolldown/plugin-babel과 플러그인이 제공하는 reactCompilerPreset을 사용합니다.
// vite.config.ts
import { defineConfig } from 'vite'
import react, { reactCompilerPreset } from '@vitejs/plugin-react'
import babel from '@rolldown/plugin-babel'

export default defineConfig({
  plugins: [react(), babel({ presets: [reactCompilerPreset()] })],
})
6.1.0(2026년 8월)부터는 Babel 없이 Rust로 작성된 oxc-transform-react를 쓰는 react({ compiler: true }) 옵션도 있지만, 아직 실험 단계입니다. @vitejs/plugin-react 5.x(Vite 7 이하)에서는 내부 Babel이 남아 있어 기존 react({ babel: { plugins: [...] } }) 방식이 그대로 동작합니다.
React 17, 18 런타임 패키지
컴파일된 코드는 react/compiler-runtime에서 c를 import 하는데, 이 모듈은 React 19에 들어 있습니다. 17이나 18에서는 react-compiler-runtime 패키지를 따로 설치하고 target을 지정합니다.
yarn add react-compiler-runtime@latest # React 19 의 react/compiler-runtime 을 대신하는 패키지['babel-plugin-react-compiler', { target: '18' }] // 출력 코드가 react-compiler-runtime 을 import 하도록적용 확인
React DevTools의 Components 탭에서 컴파일된 컴포넌트 옆에 Memo ✨ 배지가 표시됩니다.
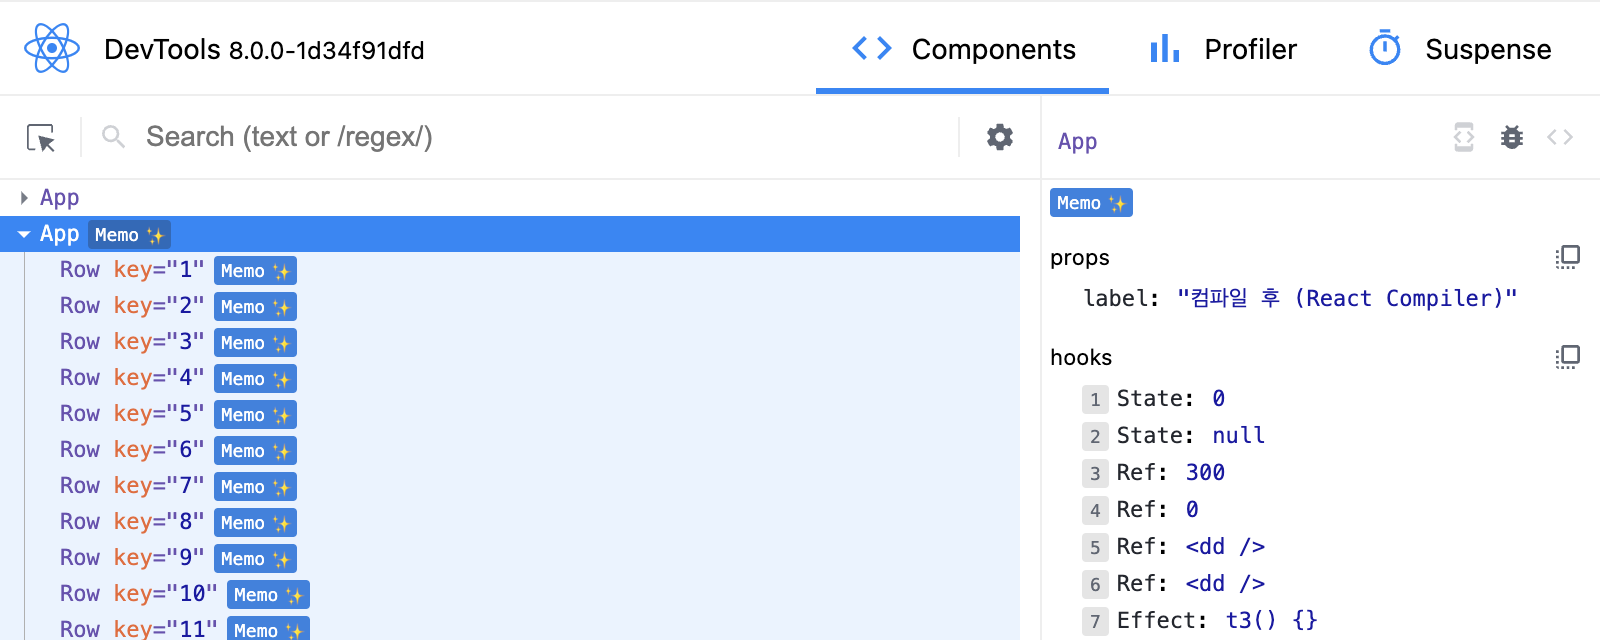
위 캡처는 뒤의 직접 비교해 보기 절에서 소개할 compare.html을 DevTools에 연결한 것입니다. 위쪽의 컴파일 전 App에는 배지가 없고, 아래쪽의 컴파일 후 App과 모든 Row에는 Memo ✨ 배지가 붙어 있습니다. 빌드 결과물에서 react/compiler-runtime import 와 _c( 호출을 찾아보는 방법도 있습니다.
점진적 도입
처음부터 전체 프로젝트에 컴파일러를 적용하는 대신, 범위를 좁혀 시작할 수 있는 여러 방법이 있습니다.
지시어: 함수 단위
컴포넌트나 훅의 첫 줄에 지시어를 쓰면 그 함수만 컴파일 대상에서 넣거나 뺄 수 있습니다. 소스 코드에 쓰는 것이라 도구와 무관합니다.
const Legacy = () => {
  'use no memo' // 이 컴포넌트는 컴파일하지 않음
  // ...
}

const Modern = () => {
  'use memo' // annotation 모드에서 이 컴포넌트만 컴파일
  // ...
}
파일 최상단(import 보다 앞)에 쓰면 파일 전체에 적용됩니다. "use no memo"와 "use memo"가 겹치면 "use no memo"가 이깁니다. 파일에 "use no memo"를 두면 함수에 "use memo"를 써도 컴파일되지 않고, 파일에 "use memo"를 두고 한 함수에만 "use no memo"를 쓰면 그 함수만 빠집니다. "use no memo"는 문제를 격리하기 위한 임시 장치로, 왜 뺐는지 주석과 함께 남기고 원인을 고친 뒤 제거하는 것이 좋습니다. 철자가 틀리면 조용히 무시되니 주의해야 합니다.
compilationMode: 기본 범위
compilationMode는 어떤 함수를 컴파일할지 정합니다.
| 값 | 동작 |
|---|---|
'infer' (기본값) | 이름과 내용으로 컴포넌트·훅을 추론해 컴파일합니다. 지시어가 있으면 지시어를 따릅니다. |
'annotation' | "use memo"가 있는 함수만 컴파일합니다. 하나씩 켜 가며 도입할 때 사용합니다. |
'all' | 파일 가장 바깥에 선언된 모든 함수를 컴파일합니다. |
'all'은 컴포넌트가 아닌 함수에도 훅 호출이 들어가기 때문에 권장하지 않습니다.
- 컴파일러가 넣는
const $ = _c(n)은 내부적으로useMemoCache라는 훅입니다. 파일 가장 바깥의 유틸 함수에 이 코드가 들어가면, 렌더링 바깥에서 호출될 때 훅 호출 규칙 위반으로 실패합니다(개발 모드에서는 "Invalid hook call" 경고가 함께 출력됩니다).- 인자로 받은 객체의 속성을 고치는(
obj.x = 1) 평범한 함수도 React 규칙 위반으로 걸려 조용히 건너뛰어집니다. lint는 컴포넌트와 훅만 검사하기 때문에 알려 주지도 않습니다. 컴포넌트가 아닌 함수에 순수성 규칙을 강제할 이유가 없습니다.- 메모이제이션이 의미 없는 함수에도 캐시 배열과 비교 코드가 붙어 번들만 커집니다.
React 문서도 React와 무관한 함수까지 컴파일할 수 있고 유틸 함수를 컴파일하면 성능이 오히려 나빠질 수 있다며 권장하지 않습니다. 실무에서는
'infer'를 기본으로 쓰고, 더 좁히고 싶을 때'annotation'을 쓰는 두 가지면 충분합니다.
Babel
// babel.config.js
module.exports = {
  plugins: [['babel-plugin-react-compiler', { compilationMode: 'annotation' }]],
}
Vite
// vite.config.ts
export default defineConfig({
  plugins: [react(), babel({ presets: [reactCompilerPreset({ compilationMode: 'annotation' })] })],
})
Next.js
// next.config.ts
const nextConfig: NextConfig = {
  reactCompiler: { compilationMode: 'annotation' },
}
webpack
// webpack.config.js
{
  loader: reactCompilerLoader,
  options: defineReactCompilerLoaderOption({ compilationMode: 'annotation' }),
}
디렉터리 단위
새로 작성하는 디렉터리부터 켜고 레거시는 나중에 옮기는 방식입니다. 이것은 babel-plugin-react-compiler 플러그인 옵션이 아니라 "어떤 파일에 플러그인을 돌릴지"의 문제라서 도구마다 방법이 다릅니다.
Babel
overrides로 플러그인을 적용할 경로를 지정합니다. babel.config.js를 그대로 읽는 React Native의 Metro도 같은 방법을 씁니다.
// babel.config.js
module.exports = {
  overrides: [
    {
      test: ['./src/features/**'],
      plugins: ['babel-plugin-react-compiler'],
    },
  ],
}
Expo는 babel-preset-expo가 컴파일러 플러그인을 대신 붙이기 때문에 overrides를 쓰지 않고, 프리셋의 'react-compiler' 옵션에 파일 이름을 받아 true/false를 반환하는 sources 함수를 넘겨 대상 파일을 거릅니다. 컴파일러 자체는 app.json의 experiments.reactCompiler로 켭니다.
// babel.config.js
module.exports = (api) => {
  api.cache(true)
  return {
    presets: [
      [
        'babel-preset-expo',
        {
          'react-compiler': {
            sources: (filename) => filename.includes('src/features'),
          },
        },
      ],
    ],
  }
}
Vite
@rolldown/plugin-babel은 babel.config.js를 읽지 않습니다. reactCompilerPreset()이 반환하는 객체에 경로로 거르는 id 필터를 추가해 제한합니다.
// vite.config.ts
const preset = reactCompilerPreset()
preset.rolldown.filter ??= {}
preset.rolldown.filter.id = { exclude: ['src/legacy/**'] }

export default defineConfig({
  plugins: [react(), babel({ presets: [preset] })],
})
Next.js
Next.js는 디렉터리 단위로 지정할 수 없습니다. reactCompiler 옵션에 경로 옵션이 없고, babel.config.js의 overrides도 무시합니다. 디렉터리 단위로 가려면 compilationMode: 'annotation'을 켜고 원하는 컴포넌트와 훅의 함수 첫 줄에 "use memo"를 적습니다. annotation 모드는 함수 안의 지시어만 보기 때문에 파일 최상단에 적어서는 안 됩니다.
webpack
로더 규칙의 include로 경로를 제한합니다. 일반 webpack 규칙과 같습니다.
// webpack.config.js
{
  test: /\.[jt]sx?$/,
  include: path.resolve(__dirname, 'src/features'),
  use: [
    'babel-loader',
    { loader: reactCompilerLoader, options: defineReactCompilerLoaderOption({}) },
  ],
}
게이팅: 사용자 단위
앞의 방법들이 어떤 컴포넌트를 컴파일할지 정한다면, gating은 어떤 사용자에게 컴파일된 코드를 줄지 정합니다. 옵션을 사용하면 컴파일러가 컴포넌트마다 컴파일된 버전과 원본 버전을 모두 번들에 포함하고, 지정한 함수를 호출해 런타임에 둘 중 하나를 고릅니다. A/B 테스트나 일부 사용자에게만 먼저 배포할 때 사용합니다.
설정에는 "고르는 함수"가 어느 모듈(source)의 어떤 이름(importSpecifierName)인지만 적습니다. source에 적은 문자열이 그대로 import 경로가 되기 때문에 상대 경로보다는 경로 별칭이나 패키지 이름을 씁니다. Next.js의 reactCompiler 옵션에는 gating이 없어 지원하지 않습니다.
Babel
// babel.config.js
module.exports = {
  plugins: [['babel-plugin-react-compiler', {
    gating: { source: '@/lib/ReactCompilerFeatureFlags', importSpecifierName: 'isCompilerEnabled' },
  }]],
}
Vite
// vite.config.ts
reactCompilerPreset({
  gating: { source: '@/lib/ReactCompilerFeatureFlags', importSpecifierName: 'isCompilerEnabled' },
})
webpack
// webpack.config.js
defineReactCompilerLoaderOption({
  gating: { source: '@/lib/ReactCompilerFeatureFlags', importSpecifierName: 'isCompilerEnabled' },
})
고르는 함수는 컴파일러가 만들어 주는 것이 아니라 직접 작성합니다. 인자 없이 호출되어 true를 돌려주면 컴파일 버전, false를 돌려주면 원본을 씁니다. 판단 기준은 자유입니다.
// src/lib/ReactCompilerFeatureFlags.ts
// 직접 작성하는 파일. 설정의 importSpecifierName 과 같은 이름으로 export 합니다.
export const isCompilerEnabled = (): boolean => {
  // 개발자가 강제로 켜고 끄는 스위치
  const override = localStorage.getItem('react-compiler')
  if (override === 'on') return true
  if (override === 'off') return false

  // 사용자 일부에게만 점진 배포 (예: 사용자 ID 해시의 끝자리로 10%)
  const userId = localStorage.getItem('user-id') ?? ''
  return hash(userId) % 100 < 10
}Counter를 이 설정으로 컴파일하면 아래처럼 두 벌의 함수와 삼항식이 생깁니다.
import { isCompilerEnabled } from '@/lib/ReactCompilerFeatureFlags'

export const Counter = isCompilerEnabled()
  ? () => { /* 컴파일된 본문 */ }
: () => { /* 원본 본문 */ }isCompilerEnabled()는 이 모듈이 처음 import 될 때 한 번만 호출되고, 그 결과가 모듈이 살아 있는 동안 유지됩니다. 브라우저에서는 번들이 로드될 때, SSR 서버에서는 프로세스가 모듈을 import 할 때입니다. 그래서 이 함수는 API 응답을 기다리는 비동기 함수일 수 없고, 호출 즉시 true나 false를 반환해야 합니다. 컴파일된 코드와 원본 코드가 번들에 모두 들어가 크기가 늘어나기 때문에, 전환이 끝나면 gating 옵션을 제거합니다.
규칙 위반을 빌드 에러로
앞의 옵션들이 어디까지 컴파일할지를 정했다면, panicThreshold는 컴파일러가 규칙 위반을 만났을 때 조용히 건너뛸지, 빌드를 실패시킬지 정합니다.
| 값 | 동작 |
|---|---|
'none' (기본값) | 코드를 분석하다 나온 에러는 어떤 것이든 빌드를 실패시키지 않고 해당 함수만 건너뜁니다. 다만 compilationMode: 'bogus'처럼 컴파일러 옵션 자체가 잘못된 경우는 'none'이어도 빌드가 실패합니다. |
'critical_errors' | React 규칙 위반이나 기존 useMemo, useCallback의 의존성 불일치처럼 코드 자체가 잘못된 경우만 빌드 에러로 만듭니다. 제너레이터 함수나 try/finally처럼 코드는 멀쩡하지만 컴파일러가 아직 지원하지 않는 문법 때문에 건너뛰는 경우는 에러로 만들지 않습니다. |
'all_errors' | 컴파일러가 지원하지 않는 문법 등 모든 건너뛰기를 빌드 에러로 만듭니다. 코드가 틀리지 않아도 빌드가 깨질 수 있습니다. |
개발 중에는 'critical_errors'로 두어 위반을 넣는 순간 바로 알아차리게 하고, 운영 빌드에는 'none'을 두어 컴파일러 문제로 배포가 막히지 않게 하는 구성이 일반적입니다.
Babel
// babel.config.js
const panicThreshold = process.env.NODE_ENV === 'production' ? 'none' : 'critical_errors'

module.exports = {
  plugins: [['babel-plugin-react-compiler', { panicThreshold }]],
}
Vite
// vite.config.ts
export default defineConfig(({ mode }) => ({
  plugins: [
    react(),
    babel({
      presets: [reactCompilerPreset({ panicThreshold: mode === 'production' ? 'none' : 'critical_errors' })],
    }),
  ],
}))
Next.js
// next.config.ts
const nextConfig: NextConfig = {
  reactCompiler: {
    panicThreshold: process.env.NODE_ENV === 'production' ? 'none' : 'critical_errors',
  },
}
webpack
// webpack.config.js
defineReactCompilerLoaderOption({
  panicThreshold: process.env.NODE_ENV === 'production' ? 'none' : 'critical_errors',
})'critical_errors'로 설정한 뒤 앞서 본 렌더링 중 ref.current를 읽는 컴포넌트를 Vite로 빌드하면 아래처럼 실패합니다. 어느 파일의 어느 줄이 왜 문제인지까지 알려 줍니다.
성능은 얼마나 좋아지나
컴파일러는 리렌더링을 줄이는 도구이기 때문에 "부모의 상태 변경이 무관한 자식까지 끌고 가는 일"이 얼마나 많은지에 따라 도입 후 성능 효과가 달라집니다.
직접 비교해 보기
같은 컴포넌트를 컴파일하지 않은 것과 컴파일한 것을 나란히 두고 비교해 보겠습니다. 부모 컴포넌트가 count 상태와 300행짜리 리스트를 가지고 있고, 각 행은 약간의 계산을 하며 렌더링될 때마다 붉게 반짝입니다. 버튼을 누르면 부모의 count만 바뀝니다.
// App.jsx (일부 생략)
const ROWS = 300
const items = Array.from({ length: ROWS }, (_, i) => ({ id: i + 1, name: `item ${i + 1}` }))

// 행 하나를 그릴 때 드는 약간의 계산 (실제 앱의 포맷팅·필터링 등을 흉내)
const format = (n) => {
  let s = 0
  for (let i = 0; i < 20000; i++) s = (s + n * i) % 9973
  return s
}

const Row = ({ item, onSelect, onRender }) => {
  const ref = useRef(null)
  useEffect(() => {
    // 이 이펙트는 Row 가 렌더링될 때마다 실행됩니다. 렌더링 횟수를 세고 행을 잠깐 반짝입니다.
    onRender()
    // ... ref.current 에 flash 클래스를 붙였다 떼는 코드
  })
  return (
    <li ref={ref} onClick={() => onSelect(item.id)}>
      {item.name} <span className="dim">{format(item.id)}</span>
    </li>
  )
}

export const App = ({ label }) => {
  const [count, setCount] = useState(0)
  const [selected, setSelected] = useState(null)
  const rowRenders = useRef(0)
  const rendersRef = useRef(null)
  // ...

  const onRender = () => {
    rowRenders.current += 1
  }
  const onClick = () => {
    // ... 클릭 시각 기록
    setCount(count + 1)
  }

  useEffect(() => {
    // 렌더링과 커밋이 끝난 시점. 자식 Row 의 이펙트가 먼저 실행되기 때문에 누적 횟수가 정확합니다.
    rendersRef.current.textContent = String(rowRenders.current)
    // ... 클릭부터 커밋까지 걸린 시간도 함께 표시
  })

  return (
    <section className="panel">
      <h2>{label}</h2>
      <div className="controls">
        <button onClick={onClick}>count + 1</button>
        {/* ... */}
      </div>
      <dl>
        {/* ... */}
        <dt>Row 누적 렌더링 횟수</dt>
        <dd ref={rendersRef}>0</dd>
      </dl>
      <ul>
        {items.map((item) => (
          <Row key={item.id} item={item} onSelect={setSelected} onRender={onRender} />
        ))}
      </ul>
    </section>
  )
}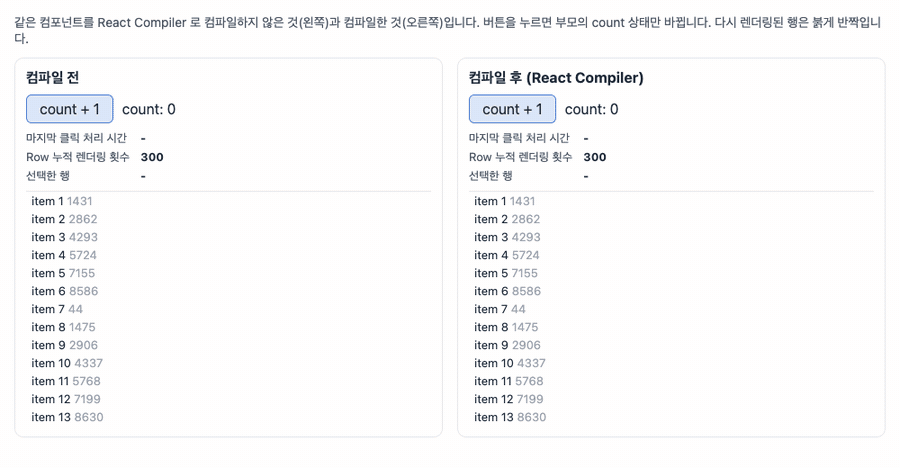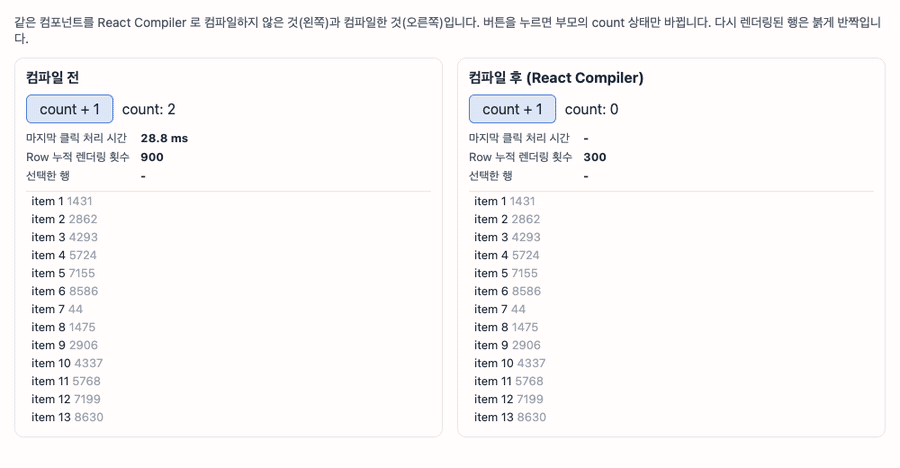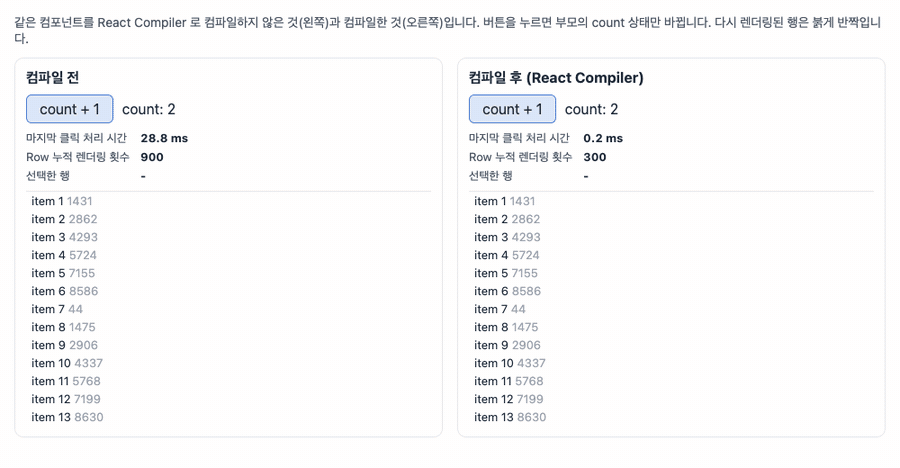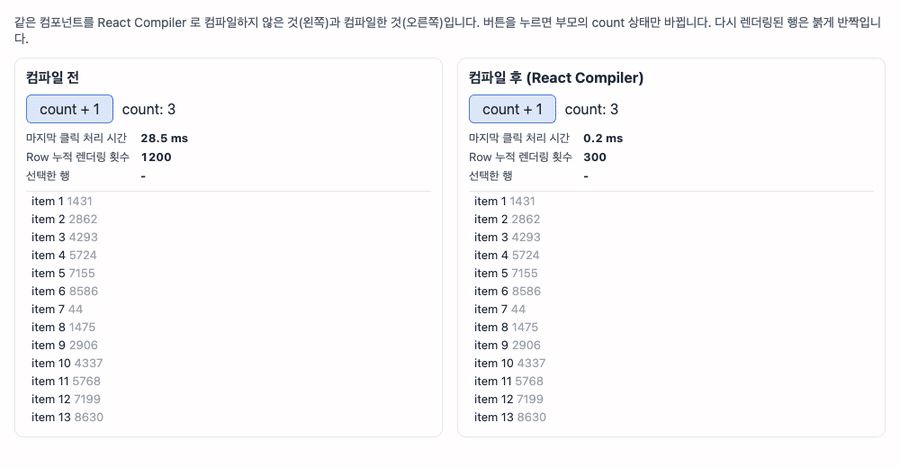
compare.html에서 직접 눌러 볼 수 있습니다. 컴파일 전후 코드는 babel-plugin-react-compiler 1.0.0을 쓰는 compile.mjs 스크립트로 App.jsx를 변환한 결과입니다. 컴파일 전은 브라우저가 읽을 수 있도록 JSX 변환만 거쳤고, 컴파일 후는 컴파일러 플러그인을 켠 뒤 같은 JSX 변환을 거쳤습니다. 컴파일 전(왼쪽)은 버튼을 누를 때마다 300개 행이 전부 반짝이고 클릭 한 번에 약 26~29ms가 걸립니다. 컴파일 후(오른쪽)는 행이 하나도 반짝이지 않고 0.2ms면 끝납니다. 컴파일러는 Row에 넘기는 onRender를 한 번만 만들고 재사용하기 때문에 items, onSelect, onRender 모두 변경되지 않아 리스트 JSX를 비교하지 않습니다. 첫 렌더링 때 만들어진 JSX를 계속 캐시에서 꺼내 쓰게 되어 300개 Row의 리렌더링이 발생하지 않습니다.
| 조건 (300행, 부모 state 200회 변경) | 컴파일 전 | 컴파일 후 |
|---|---|---|
| 행마다 무거운 계산이 있는 리스트 | 534~623ms | 7~9ms |
| 계산이 없는 가벼운 리스트 | 282~353ms | 7~9ms |
자식에 인라인 객체 style={{ ... }}를 넘기는 리스트 | 329~404ms | 6~9ms |
위 표는 같은 구조를 jsdom + React 19에서 반복 실행해 잰 것입니다. 앞의 브라우저 데모는 행마다 강제 리플로우가 포함된 수치라 한 번 클릭에 걸리는 시간이 이 표의 한 회분보다 큽니다.
행의 계산이 가벼워도 차이가 큰 이유는, 300개 컴포넌트를 다시 실행하고 비교(Reconciliation)하는 비용 자체가 사라지기 때문입니다. 세 번째 줄의 인라인 객체 style={{ ... }}는 컴파일 전에는 렌더링마다 새로운 객체가 되어 자식을 memo로 감싸도 매번 리렌더링됩니다. 컴파일러는 이런 객체 리터럴도 함께 캐시해 매번 같은 참조를 넘기기 때문에, 컴파일 후에는 인라인 객체가 있어도 문제가 되지 않습니다.
주의할 점
컴파일러를 실제 프로젝트에 적용하면서 겪는 문제들입니다.
기존 수동 메모이제이션은 그대로 둔다
컴파일러를 도입할 때 기존 코드의 useMemo, useCallback을 미리 걷어낼 필요는 없습니다. 컴파일러가 이 훅들을 분석해서 자신의 Reactive Scope로 바꿔 넣고, 그대로 보장할 수 없는 경우에는 그 컴포넌트만 건너뛰기 때문에, 걷어내는 작업은 컴파일러가 안정적으로 돌아간 뒤 해도 늦지 않습니다.
아래 표는 컴파일러가 사람이 작성한 useMemo를 어떻게 처리하는지 정리한 것입니다. useCallback은 결과가 항상 함수라 객체와 같은 첫 세 행에 해당합니다.
| 기존 코드 | 컴파일 결과 |
|---|---|
useMemo(() => ({ a, b }), [a, b]) (객체) | a, b에 의존하는 Reactive Scope로 바꿔 넣음 |
useMemo(() => ({ a, b }), [a]) (객체, 의존성 누락) | 컴포넌트 전체를 건너뜀 |
useMemo(() => ({ a }), [a, b]) (객체, 쓰지 않는 의존성 포함) | a에만 의존하는 Reactive Scope로 바꿔 넣음. 남는 의존성은 무시 |
useMemo(() => a + b, [a, b]) (연산으로 만든 원시 값) | useMemo를 벗겨 내고 매 렌더링마다 계산 |
useMemo(() => a + b, [a]) (연산으로 만든 원시 값, 의존성 누락) | 건너뛰지 않고 똑같이 useMemo를 벗겨 냄. b가 바뀌면 다시 계산되어 동작이 달라짐 |
useMemo(() => heavy(a), [a]) (함수 호출로 얻은 원시 값) | a에 의존하는 Reactive Scope로 바꿔 넣음 |
useMemo(() => heavy(a, b), [a]) (함수 호출로 얻은 원시 값, 의존성 누락) | 컴포넌트 전체를 건너뜀 |
useMemo(() => { /* 무거운 루프 */ }, [a]) (인라인 루프로 만든 원시 값) | useMemo를 벗겨 내고 루프를 매 렌더링마다 실행 |
useMemo(() => ({ a, b }), [a, b]) (객체)
사람이 작성한 의존성이 컴파일러의 분석과 일치하면, useMemo 없이 { a, b }를 적은 코드를 컴파일한 것과 동일하게 a, b에 의존하는 Reactive Scope로 바꿔 넣습니다.
useMemo(() => ({ a, b }), [a]) (객체, 의존성 누락)
의존성이 다르면 그 컴포넌트 전체를 건너뜁니다. 아래처럼 의존성 배열에서 b를 빠뜨린 경우, 컴파일러의 분석으로는 b가 바뀌면 v도 바뀌어야 하기 때문에 기존 메모이제이션을 그대로 보장할 수 없습니다. 이때는 Existing memoization could not be preserved라는 이유로 그 컴포넌트의 컴파일을 건너뜁니다.
const Wrong = ({ a, b }) => {
  const v = useMemo(() => ({ a, b }), [a]) // b 누락 → 이 컴포넌트 전체를 건너뜀
  return <Child v={v} />
}
useMemo(() => ({ a }), [a, b]) (객체, 쓰지 않는 의존성 포함)
계산에 쓰지 않는 b가 의존성에 들어 있는 경우는 건너뛰지 않습니다. 값이 실제로 b에 의존하지 않아, a에만 의존하는 Reactive Scope를 만들고, 남는 b는 무시합니다.
useMemo(() => a + b, [a, b]) (연산으로 만든 원시 값)
결과가 숫자나 문자열 같은 원시 값이면 참조를 유지할 이유가 없기 때문에 Reactive Scope로 바꿔 넣는 대신 useMemo 자체를 벗겨 내어 const v = a + b로 바꿉니다.
참조를 유지해야 하는 이유
useMemo로 참조를 유지하는 이유는, 객체나 배열은 내용이 같아도 새로 만들면!==라서,memo로 감싼 자식이나useEffect의존성 배열이 "값이 바뀌었다"고 판단하기 때문입니다. 반면 숫자나 문자열은 다시 계산해도3 === 3처럼 같아서 자식이 리렌더링되거나 이펙트가 재실행되지 않습니다.
useMemo(() => a + b, [a]) (연산으로 만든 원시 값, 의존성 누락)
b가 바뀌어도 옛 값을 유지하려고 의존성을 일부러 뺀 경우 주의해야 합니다. 결과가 원시 값이면 컴파일러가 useMemo를 벗겨 내기 때문에 b가 바뀔 때마다 다시 계산되어 동작이 달라집니다. 이때는 건너뛰지도 않고 에러도 발생하지 않습니다. React에서는 의존성 배열에 계산에 쓰인 값을 빠짐없이 적는 것이 규칙이기 때문에, 값을 고정하려는 의도라면 useState(() => a + b)나 useRef처럼 의도가 드러나는 방법으로 바꿔야 합니다.
useMemo(() => heavy(a), [a]) (함수 호출로 얻은 원시 값)
함수를 호출해 얻는 값은 비용을 알 수 없기 때문에 원시 값이어도 a에 의존하는 Reactive Scope로 바꿔 넣어 캐시를 유지합니다.
useMemo(() => heavy(a, b), [a]) (함수 호출로 얻은 원시 값, 의존성 누락)
함수 호출 결과를 캐시하기 때문에 b가 빠지면 기존 메모이제이션을 보장할 수 없어 컴포넌트 전체를 건너뜁니다.
useMemo(() => { /* 무거운 루프 */ }, [a]) (인라인 루프로 만든 원시 값)
무거운 계산을 함수로 분리하지 않고 useMemo 안에 루프로 직접 적은 코드는 주의해야 합니다. 결과가 원시 값이면 컴파일러가 useMemo를 벗겨 내고 루프를 매 렌더링마다 실행하기 때문에 컴파일 전보다 느려집니다. 무거운 계산은 함수로 분리해 컴파일러가 그 호출 결과를 캐시하게 하는 것이 좋습니다.
새로 작성하는 코드에서는 성능을 위한 useMemo, useCallback은 쓰지 않고 컴파일러에 맡깁니다. 다만 아래 코드처럼 참조가 바뀌면 동작까지 달라지는 경우는 예외입니다.
const options = useMemo(() => ({ id }), [id]) // 컴파일러에 맡기지 않고 직접 고정
useEffect(() => {
  connect(options) // options 참조가 바뀔 때마다 다시 연결됨
}, [options])
useMemo 없이 const options = { id }로 쓰고 컴파일러에 맡겼다면, 나중에 규칙 위반 코드가 추가되는 등의 이유로 컴파일러가 이 컴포넌트를 건너뛰는 순간 options가 렌더링마다 새 객체가 되어 이펙트가 매번 재실행됩니다. 이런 값은 위처럼 useMemo로 직접 만들어 참조를 고정해 둡니다. 기존 코드의 useMemo를 지우는 것도 같은 이유로 결과가 달라질 수 있기 때문에, 지운다면 테스트로 확인하는 것이 좋습니다.
memo로 감싼 컴포넌트도 그대로 둘 수 있습니다. 컴파일러는 memo(...) 호출은 건드리지 않고 안쪽 함수 본문만 바꾸기 때문에, memo의 props 비교와 컴파일러의 캐시가 함께 동작하고 서로 방해하지 않습니다.
동작이 바뀌는 코드
가장 흔한 문제는 어떤 값이 매 렌더링마다 새로 만들어지는 것을 예상했던 코드가, 컴파일 후 그 값이 캐시되면서 다르게 동작하는 경우입니다.
const Search = ({ query }) => {
  const options = { query, page: 1 }

  useEffect(() => {
    fetchResults(options)
  }, [options])
  // ...
}
컴파일 전에는 options가 매 렌더링마다 새 객체라 이펙트가 매번 실행되었습니다. 컴파일 후에는 options가 query에 의존하는 Reactive Scope가 되어 query가 같으면 같은 객체이고, 이펙트는 query가 바뀔 때만 실행됩니다. 이것이 의도한 동작이라면 버그가 고쳐진 것이고, 매번 실행되는 것에 기대고 있었다면 동작이 바뀐 것입니다.
캐시가 잘못 작동하는 문제도 있습니다. 순수성 규칙을 어기고 props나 state에서 온 객체를 렌더링 중에 변경하면 참조는 그대로인 채 내용만 바뀌기 때문에 캐시 비교가 어긋나고, 이펙트가 예상보다 자주 실행되거나 무한 루프에 빠지기도 합니다. user.name = 'x'처럼 컴포넌트 안에서 눈에 보이게 변경하는 코드는 lint가 잡아 주지만, sort()처럼 컴파일러가 모델링하지 않은 메서드나 다른 함수 안에 숨은 변경은 lint도 놓칩니다.
이런 문제가 의심되는 컴포넌트에 "use no memo"를 붙여 컴파일에서 빼 봅니다. 그렇게 해서 증상이 사라진다면 컴파일러 버그라기보다 그 컴포넌트에 숨어 있던 React 규칙 위반이 드러난 것이니, 컴파일러를 끄는 대신 위반한 코드를 고쳐야 합니다.
캐시는 인스턴스마다 따로
캐시 배열은 컴포넌트 인스턴스마다 따로 만들어지기 때문에, 다른 컴포넌트나 같은 컴포넌트의 다른 인스턴스와 공유되지 않습니다. 여러 컴포넌트가 같은 무거운 계산을 한다면 각자 계산하기 때문에, 이런 경우는 직접 캐시를 관리하는 것이 좋습니다.
비교는 얕은 비교
Reactive Scope는 의존성을 !==로 비교합니다. useMemo의 의존성 비교와 마찬가지로 참조만 보는 얕은 비교라, 내용이 같아도 참조가 다르면 다시 계산합니다. 그래서 컴파일되지 않은 부모가 매 렌더링마다 새 객체를 props로 넘기면 컴파일된 자식도 매번 다시 계산합니다. 외부 라이브러리의 훅이 호출할 때마다 새 객체를 반환하는 경우도 마찬가지입니다. 부모까지 컴파일되면 그 객체도 캐시되어 참조가 유지되기 때문에, 프로젝트 전체에 적용할수록 효과가 커집니다.
런타임 비용
컴파일된 코드는 원본보다 길고, 렌더링마다 캐시 칸을 비교하는 연산이 추가됩니다. 매우 단순한 컴포넌트에서는 비교 비용이 절약되는 비용보다 클 수도 있습니다.
라이브러리 배포 시 React 19 요구
라이브러리를 컴파일해서 배포하면, 그 라이브러리를 쓰는 앱은 컴파일러를 설치하지 않아도 메모이제이션된 코드를 받습니다. 다만 컴파일된 코드는 React 19에 들어 있는 react/compiler-runtime을 import 하기 때문에, 라이브러리가 React 19 이상을 요구하게 됩니다. 17이나 18까지 지원하려면 React 17, 18 런타임 패키지 절처럼 target을 낮추고 react-compiler-runtime 패키지를 라이브러리의 의존성에 추가해야 합니다.
참고
- https://react.dev/learn/react-compiler/introduction
- https://react.dev/learn/react-compiler/installation
- https://react.dev/learn/react-compiler/incremental-adoption
- https://react.dev/learn/react-compiler/debugging
- https://react.dev/reference/react-compiler/configuration
- https://react.dev/reference/react-compiler/directives
- https://react.dev/blog/2025/10/07/react-compiler-1
- https://react.dev/reference/rules
- https://nextjs.org/docs/app/api-reference/config/next-config-js/reactCompiler
- https://github.com/vitejs/vite-plugin-react/blob/main/packages/plugin-react/README.md
- https://oxc.rs/blog/2026-08-18-react-compiler-support
- https://playground.react.dev